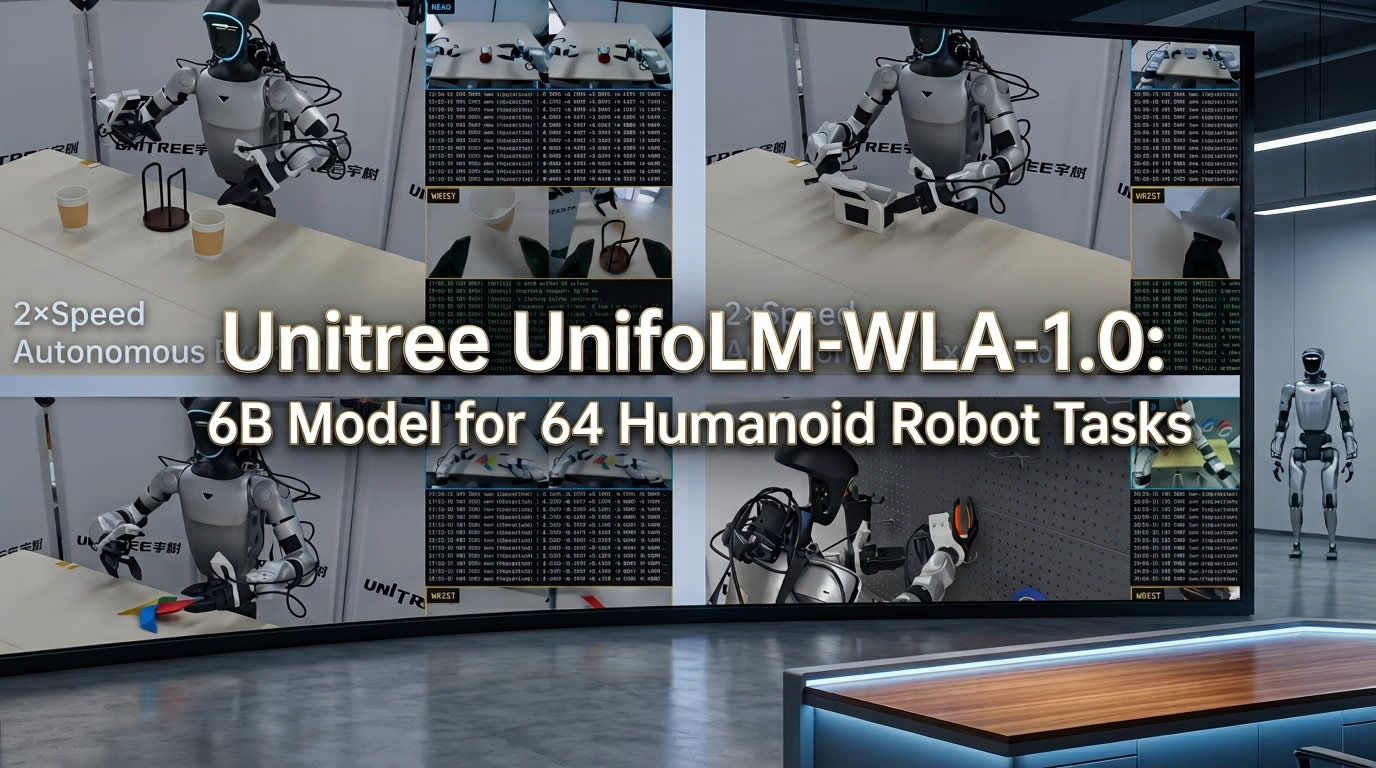
Unitree publicó nuevos detalles sobre UnifoLM-WLA-1.0, su más reciente modelo fundacional para robots humanoides de propósito general. Según la compañía, el modelo reúne la manipulación de precisión sobre mesa y la manipulación móvil de cuerpo completo en un solo sistema, usando un espacio de acción unificado para manejar distintos efectores finales. El objetivo de Unitree es usar un solo modelo para toda la cadena, desde la percepción y las decisiones de interacción hasta la generación de acciones.
El modelo tiene 6,000 millones de parámetros. Unitree dice que fue entrenado con unas 2,500 horas de datos de alta calidad de robots reales. Las pruebas con robots reales de la compañía cubren 64 tareas: 10 tareas de manipulación de cuerpo completo y 54 tareas sobre mesa. Es compatible con pinzas paralelas y dos tipos de manos diestras.
Para los desarrolladores de robots, la cifra de 64 tareas quizá no sea lo más importante. La pregunta más grande es si el modelo puede seguir funcionando en distintos cuerpos de robot y efectores finales, y qué tan bien generaliza a tareas para las que no fue entrenado. Todavía no hay validación externa. Unitree lanzó una página de proyecto y dice que publicará el modelo, el código y los conjuntos de datos. Pero las páginas de Code, Models y Datasets todavía dicen “Próximamente”. Los pesos y los conjuntos de datos no están disponibles para descargar.
64 tareas, pero lo difícil es la coordinación
Unitree enumera tareas como sacar la basura, meter ropa en la lavadora, organizar zapatos, limpiar baños y cocinas, tender camas, recoger verduras, ordenar sofás, doblar toallas y ropa, guardar platos y cargar baterías. Diez son de manipulación de cuerpo completo; 54 son sobre mesa.
La diferencia no es solo el tamaño del espacio de trabajo. Las tareas sobre mesa a menudo pueden hacerse desde una posición relativamente fija, con el robot controlando principalmente sus brazos, manos y efectores finales. En una cocina, un baño o una recámara, el robot primero tiene que cambiar su posición y postura, y luego llevar ambos brazos al espacio de trabajo correcto. Tareas como tender una cama u ordenar un sofá requieren que las manos y el cuerpo se muevan juntos.
El enfoque de Unitree es que un solo modelo maneje ambos tipos de acción en lugar de construir modelos separados para la manipulación sobre mesa y la de cuerpo completo. El modelo tampoco está atado a una sola pinza. Unitree dice que UnifoLM-WLA-1.0 funciona con pinzas paralelas y dos tipos de manos diestras.
Un espacio de acción para manos, brazos y parte inferior del cuerpo
Para controlar todo el cuerpo de un humanoide con un solo modelo, el primer problema es cómo representar las acciones. Unitree divide las acciones en tres partes: pose del efector final, articulaciones del efector final y articulaciones de la parte inferior del cuerpo. Luego usa cuantización vectorial residual, o RVQ, para convertir acciones continuas en tokens discretos. Los tokens de distintas partes del cuerpo se alinean en pasos de tiempo compartidos y se alimentan juntos al modelo, para que pueda aprender cómo trabajan juntas las manos, los efectores finales y la parte inferior del cuerpo.
El resultado es una representación de acción discreta que el modelo puede aprender y predecir de manera unificada. El punto no es una acción individual, sino la coordinación entre acciones. Caminar hacia una lavadora, por ejemplo, no es simplemente una acción de “moverse” seguida de una acción de “agarrar”. El cuerpo tiene que llegar a la posición correcta, los brazos tienen que ajustarse y las manos tienen que operar según el objeto objetivo. Poner estas acciones en la misma línea de tiempo permite al modelo aprender cómo se relacionan entre sí.
Antes de actuar, el robot tiene que saber qué va a cambiar
Otra decisión de diseño en UnifoLM-WLA-1.0 es que no se detiene en entender la imagen actual. Si el robot está a punto de tomar un plato, necesita más que “hay un plato aquí”. También necesita saber cómo cambiará la escena después de retirar el plato, cómo se deformará una toalla al doblarla y qué partes de la escena cambiarán realmente cuando se empuje un objeto. Unitree llama a estas áreas Regiones Dinámicas.
El método usa flujo óptico para extraer regiones cambiantes de pares de fotogramas de video, y luego usa un autoencoder variacional con cuantización vectorial (VQ-VAE) para comprimir cambios continuos en tokens discretos de longitud fija. El modelo puede entonces predecir futuras regiones de cambio con base en la imagen actual, la descripción de la tarea o las condiciones de la acción. Unitree llama a esto modelado de mundo centrado en la interacción. La idea es predecir cómo cambiará la escena cuando el robot interactúe con ella, no solo describir el fotograma actual.
UnifoLM-ER-Flow une visión y acción
En este marco, Unitree coloca tokens visuales, de lenguaje, de regiones dinámicas y de acción en un modelo multimodal unificado llamado UnifoLM-ER-Flow. UnifoLM-WLA-1.0 agrega encima un módulo MMDiT Action Expert para generar acciones continuas del robot. Unitree dice que el sistema combina razonamiento encarnado, predicción de regiones dinámicas futuras y aprendizaje de acciones discretas en un solo marco multimodal.
El pipeline tiene tres partes conectadas: entender el espacio y la tarea, predecir cómo la interacción puede cambiar las cosas y luego generar acciones del robot.
2,500 horas de datos de robots reales
UnifoLM-WLA-1.0 fue entrenado con unas 2,500 horas de datos de robots reales. Unitree dice que los datos provienen de sus propios conjuntos de datos de código abierto y de recursos públicos como HIW-500, y cubren múltiples cuerpos de robot y entornos de operación. El modelo también usa un espacio de acción unificado y priors de transferencia entre cuerpos.
Esa distinción importa al llamar “modelo fundacional” a un modelo de robot. Un modelo que solo completa un conjunto de tareas en un robot fijo, con un efector final fijo y una escena fija, está más cerca de un modelo de control especializado. Un modelo fundacional debería conservar cierta capacidad de transferencia cuando cambia el hardware o la tarea. Unitree incluyó distintos cuerpos de robot, dos tipos de manos diestras y pinzas paralelas en su marco de entrenamiento y pruebas. Pero la información pública no alcanza para juzgar qué tan bien transfiere a robots de terceros. Será más fácil evaluar qué tan bien transfiere a hardware de terceros una vez que la publicación esté disponible.
5 millones de muestras de razonamiento encarnado de UnifoLM-ER-1-4B
Detrás del modelo de acción hay un modelo de razonamiento encarnado separado. UnifoLM-ER-1-4B de Unitree está basado en Qwen3-VL-4B y usa más de 5 millones de muestras de razonamiento encarnado. Los datos cubren predicción de puntos en imágenes, detección de objetos, razonamiento multiimagen, predicción de trayectorias 2D, detección de objetos 3D y respuesta a preguntas espaciales multiimagen, y se entrenan conjuntamente con datos generales de imagen y texto.
Este modelo trata principalmente sobre la comprensión espacial antes de la acción. El robot necesita saber dónde están los objetos, cómo se relacionan entre sí, dónde está la ubicación objetivo y qué partes de la escena pueden verse afectadas por sus acciones. Esa información le da al modelo de acción el contexto espacial que necesita.
Unitree reporta las mejores puntuaciones en siete benchmarks
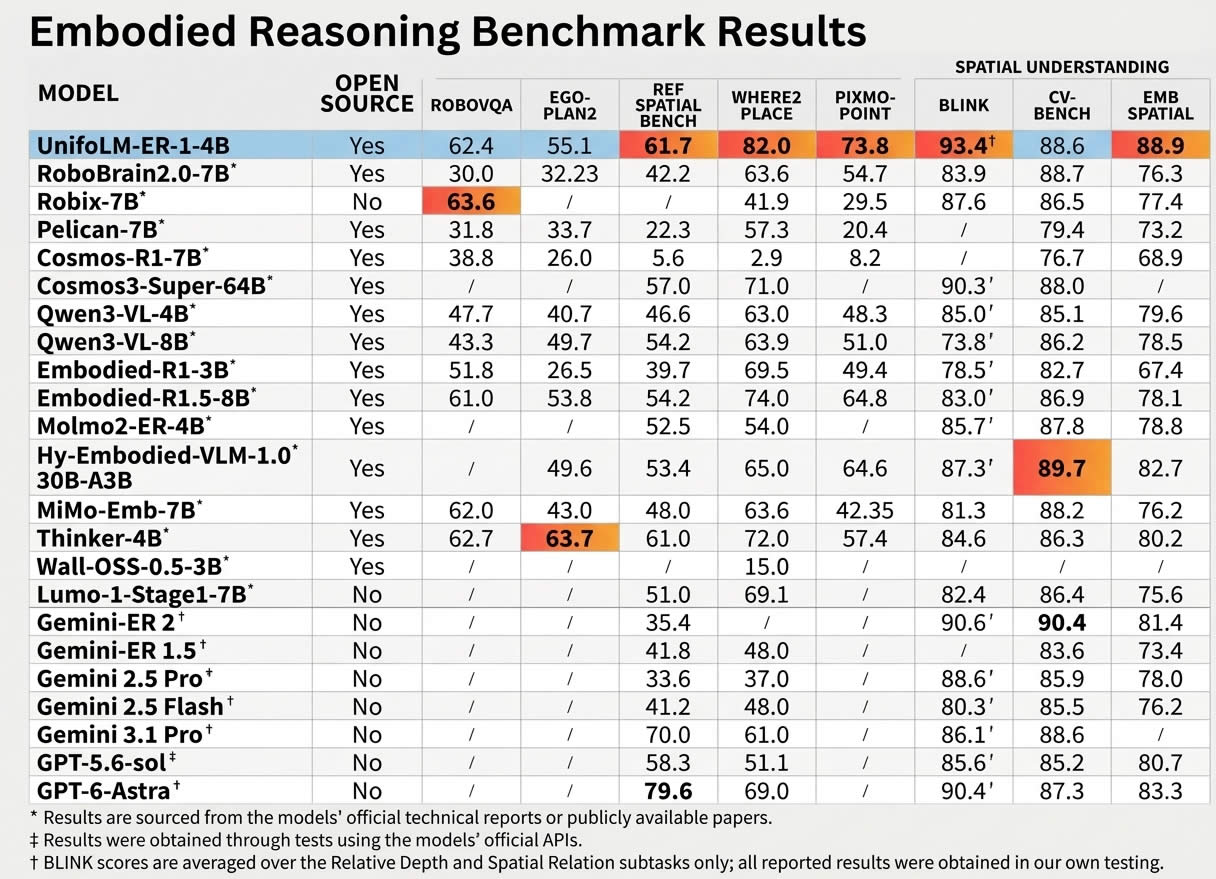
Unitree publicó resultados en 16 benchmarks de percepción y comprensión multimodal. UnifoLM-ER-1-4B obtuvo la puntuación más alta entre los modelos de código abierto evaluados en siete: RefSpatial-Bench, Where2Place, PixMo-Point, BLINK, EmbSpatial, RoboSpatial y VSR.
Las puntuaciones publicadas incluyen:
- Where2Place: 82.0
- PixMo-Point: 73.8
- EmbSpatial: 88.9
- RoboSpatial: 73.1
Unitree también compartió comparaciones con algunos modelos de código cerrado. En pruebas que ambos sistemas realizaron, UnifoLM-ER-1-4B obtuvo 82.0 en Where2Place, 13 puntos más que GPT-6 Astra; 93.4 en BLINK, 3 puntos más; 88.6 en CV-Bench, 1.3 puntos más; y 88.9 en EmbSpatial, 5.6 puntos más.
Esas cifras necesitan contexto. Son resultados de benchmarks publicados por Unitree, no clasificaciones de una organización de pruebas independiente. El material disponible no incluye reproducciones de terceros. Los resultados de benchmarks no muestran por sí solos que UnifoLM-WLA-1.0 supere a otros modelos en tareas de robots reales. La prueba más sólida serán las tasas de éxito en robots reales, los tipos de fallo y si el modelo puede transferir a otros robots sin reentrenamiento dirigido.
Plan de código abierto anunciado, pero los pesos aún no llegan
La página del proyecto UnifoLM-WLA-1.0 está en línea y Unitree dice que publicará el modelo, el código y los conjuntos de datos. Por ahora, las secciones de Code, Models y Datasets del sitio siguen marcadas como “Próximamente”. El código fuente, los pesos del modelo y los conjuntos de datos no se han publicado oficialmente para descargar.
Eso significa que los desarrolladores pueden leer sobre la arquitectura, la cobertura de tareas y los resultados de benchmarks, pero todavía no pueden descargar el paquete completo de código abierto ni reproducir el trabajo de manera independiente. La verdadera prueba llegará cuando investigadores externos puedan correr el modelo en tareas y plataformas de robots más allá de la evaluación publicada por Unitree.
Página del proyecto: https://unigen-x.github.io/unifolm-wla.github.io/
Fuente: Robots Daily